
Zwischen deinem Prompt und jedem Wort der Antwort (technisch gesehen ein Token, aber halten wir es einfach) passieren vier Dinge. Der Forward Pass bewertet jedes Token im Vokabular. Die Temperatur formt diese Bewertungen in eine Wahrscheinlichkeitsverteilung um. Top-k und Top-p entscheiden, welche Kandidaten im Rennen bleiben. Die Ziehung wählt eines aus. Sie ist die einzige Zufälligkeit in dieser Erklärung, und der Seed ist das, was sie steuert.
Hier ist, was du erwarten würdest. Drehst du die Temperatur auf null, fällt die Verteilung auf ein einziges Token zusammen. Die Ziehung ist also noch da, hat aber nichts mehr zu entscheiden. Oder du lässt die Temperatur in Ruhe und fixierst den Seed. Dann trifft die Ziehung jedes Mal dieselbe Wahl. Derselbe Prompt sollte jedes Mal mit derselben Antwort zurückkommen.
Tut er aber nicht, und die Abweichung ist nicht klein. Dieser Artikel dokumentiert, was passierte, als ich es überprüft habe.
Hinweis: Der Begleitartikel zu diesem Text ist Was sich ändert, wenn ein Teil deines Systems nicht-deterministisch ist. Um das Folgende ganz zu verstehen, lies ihn zuerst. Er argumentiert, dass nicht-deterministisch ein schwaches Wort ist, das vieles verdeckt, was du wissen musst. Er erklärt auch Temperatur, Top-k, Top-p und den Seed, die vier Hyperparameter, auf die sich dieser Artikel bezieht.
Also habe ich es gemessen
Ich habe denselben Prompt einhundert Mal an gpt-4.1-mini gesendet, fixiert auf seinen Snapshot 2025-04-14, und habe das dann fünf weitere Male mit veränderten Sampling-Einstellungen wiederholt: zwei Temperaturen, gekreuzt mit keinem Seed, einem festen Seed und einem anderen Seed bei jedem Aufruf. Sechshundert Aufrufe, nacheinander statt parallel ausgeführt. Hätte ich sie gleichzeitig abgefeuert, hätten meine eigenen Anfragen im selben Server-Batch landen können, und die Batch-Zusammensetzung wollte ich genau nicht antasten.
Der Prompt war jedes Mal derselbe, ohne Systemnachricht:
List three reasons a flaky test might pass on a retry. One sentence each.
(Nenne drei Gründe, warum ein flaky Test bei einem Retry bestehen könnte. Jeweils ein Satz.)
Zwei Antworten zählen als unterschiedlich, wenn die Strings nicht Zeichen für Zeichen identisch sind, ohne dass eine Normalisierung stattfindet.
Als separate Prüfung habe ich jede Antwort in Kleinbuchstaben umgewandelt, die Satzzeichen entfernt und die Leerzeichen zusammengezogen. Keine der sechs Zählungen unten hat sich geändert. Jeder Unterschied ist ein Unterschied in den Worten.
Das sind die Messwerte aus dem Experiment:
Das sind die Messwerte aus dem Experiment:
Einstellung | Unterschiedliche Antworten, von 100 |
Temperatur 0, kein Seed | 27 |
Temperatur 0, seed=42 bei jedem Aufruf | 30 |
Temperatur 0, ein anderer Seed bei jedem Aufruf | 27 |
Temperatur 1.0, kein Seed | 100 |
Temperatur 1.0, seed=42 bei jedem Aufruf | 26 |
Temperatur 1.0, ein anderer Seed bei jedem Aufruf | 100 |
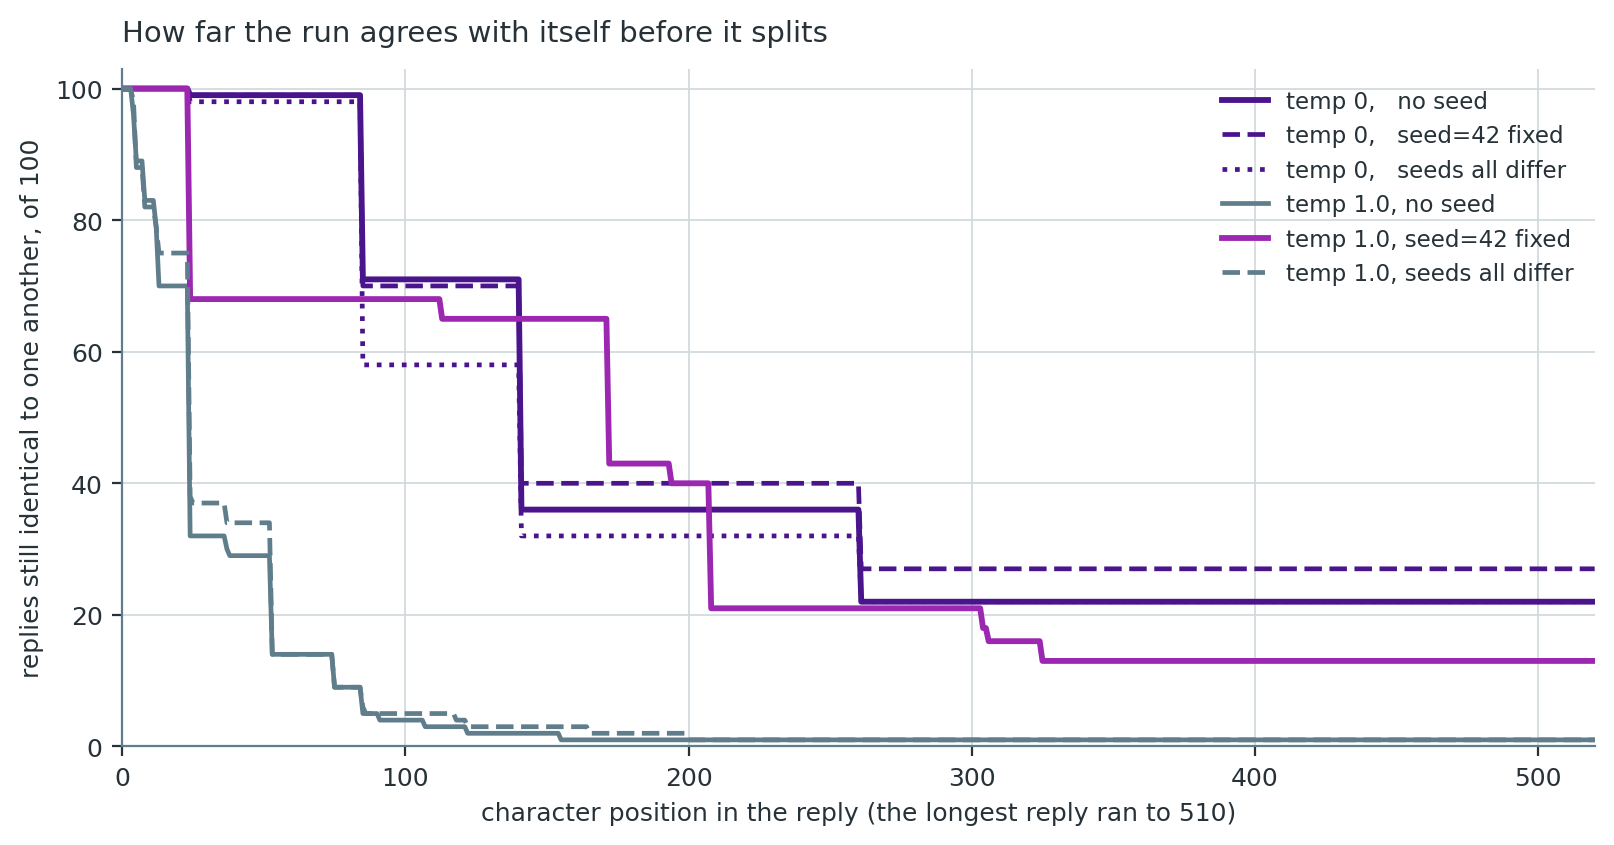
Abbildung 1
Jede Zeile in diesem Diagramm zeigt die einhundert Antworten für eine Einstellung, so sortiert, dass identische Antworten nebeneinander liegen. Ein Block ist eine unterschiedliche Antwort, und seine Breite zeigt, wie oft diese Antwort zurückkam. Die Anzahl der Blöcke in einer Zeile entspricht also der Zahl am Rand, und du kannst sie nachzählen.
Lies zuerst die Zeilen für Temperatur 1.0. Dort verhält sich der Seed so, wie du es erwarten würdest. Ohne Seed und mit einem unterschiedlichen Seed bei jedem Aufruf bestehen die Zeilen aus hundert feinen Linien: Keine einzige Antwort kam zweimal zurück. Hältst du den Seed stattdessen fest, fällt die Zeile in ein paar breite Blöcke zusammen. Der größte davon steht für dreizehn Aufrufe, die Wort für Wort dieselbe Antwort geliefert haben. Der Seed wird beachtet und leistet echte Arbeit.
Er macht aber nicht den Job, für den du ihn eingestellt hast. Ein Seed, der die Ausgabe kontrolliert, würde eine einzige Antwort hundertmal zurückgeben. Er lieferte sechsundzwanzig. Der Seed fixiert den Pfad durch die Verteilung, die er übergeben bekommt. Die wahrscheinlichste Interpretation ist, dass er nicht zweimal dieselbe Verteilung erhält.
Lies jetzt die Zeilen für Temperatur 0, wo dieselben drei Einstellungen 27, 30 und 27 produzieren. Der Seed spielt keine Rolle mehr. Genau das sagt die Pipeline voraus: Wenn die Verteilung zusammenfällt, bleibt für die Ziehung nur ein einziger Kandidat übrig. Es gibt also nichts mehr, was ein Seed steuern könnte. Es ist befriedigend zu sehen, wie eine Vorhersage den Kontakt mit hundert Aufrufen übersteht, und diese hier hat es getan.
Und dann die Sache, die nicht da sein sollte. Vier dieser sechs Einstellungen landen zwischen 26 und 30 unterschiedlichen Antworten. Diese vier kommen auf einem von zwei Wegen dorthin: Bei Temperatur null hat die Ziehung nur einen Kandidaten und trifft keine Wahl, und bei einem festen Seed bei Temperatur 1.0 trifft sie jedes Mal dieselbe Wahl. Unterschiedliche Wege, und beide enden an derselben Stelle: bei etwa 27 unterschiedlichen Antworten aus hundert.
Dieser Boden ist die Variation, die übrig bleibt, wenn der Sampler nichts mehr beitragen kann. Was auch immer noch übrig ist, keine Sampler-Einstellung erreicht es. Wo liegt es also?
Wo die Antworten auseinandergehen
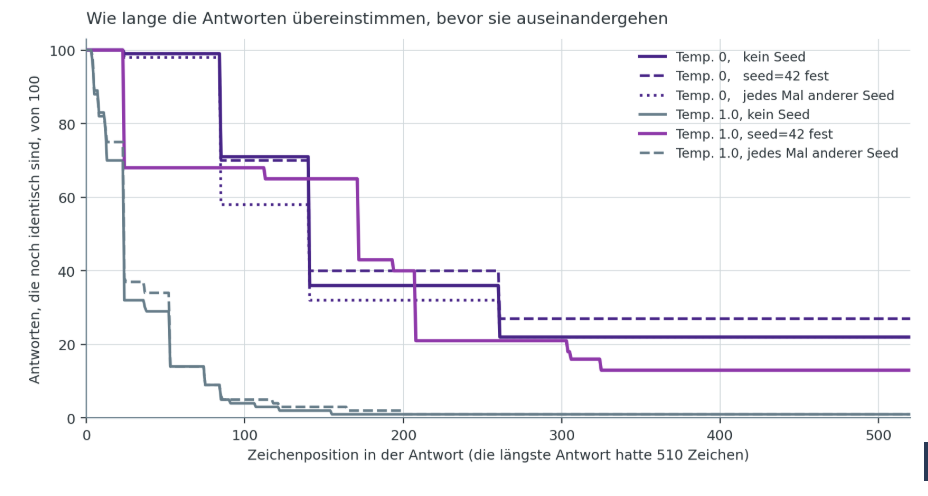
Abbildung 2
Das Diagramm oben zeigt dieselben Daten, aber diesmal entlang der Antwort gelesen statt quer dazu. Für jede Zeichenposition fragt es, wie viele der hundert Antworten noch Wort für Wort identisch zueinander sind. Dabei zählt es die größte Gruppe, die noch übereinstimmt. Wo jede Linie am Ende abflacht, ist die Breite des breitesten Blocks im früheren Diagramm. Die beiden treffen sich also am rechten Rand. Folge zum Beispiel der durchgehenden Linie für Temperatur 0, kein Seed, bis zum rechten Rand, und sie pendelt sich bei 22 ein. Das ist dieselbe 22 wie beim breitesten Block im früheren Diagramm: die größte Anzahl an Antworten, die für diese Einstellung identisch waren.
Bei Temperatur null ohne Seed sind neunundneunzig der hundert Antworten für die ersten vierundachtzig Zeichen identisch. Dann ein Schritt hinunter auf einundsiebzig, ein weiterer auf sechsunddreißig, und zweiundzwanzig davon sind den ganzen Weg über identisch. Jeder dieser Schritte ist eine Stelle, an der sich das Token mit der höchsten Bewertung geändert hat. Alles, was nach so einem Schritt kommt, ist ein anderer Satz, oder gleich mehrere.
Die beiden Durchläufe bei Temperatur 1.0 ohne festen Seed liegen genau übereinander und stürzen ab wie über eine Klippe. Bei Zeichenposition vierundachtzig, wo Temperatur null ohne Seed noch neunundneunzig übereinstimmende Antworten hat, haben sie nur noch neun.
Die Schritte sind der entscheidende Punkt. Die drei Linien für Temperatur null driften nicht auseinander, sie stimmen exakt überein, springen dann um, und stimmen auf der anderen Seite des Sprungs wieder exakt überein. Diese Variation kann von den Decoding-Einstellungen nicht erreicht werden. Bei Temperatur null haben sie nämlich nichts mehr zu entscheiden.
Mein Experiment belegt nur so viel, und der einzige Teil, den ich verteidigen kann, ist dieser:
Die Einstellungen, die wir in einer Anfrage steuern, haben einen Einfluss auf die Variation, aber die Variation verschwindet nicht. Sie ist immer noch signifikant und lässt sich nicht mit dem entfernen, was unsere Anfrage steuern kann.
Was ich dir nicht zeigen kann
Was dieses Experiment nicht belegt, ist die Ursache. Genau hier wird eine Messung leise zu einer Geschichte, wenn niemand sie aufhält.
Die Ziehung kann nichts mehr beitragen, also schaut die Standarderklärung auf den Schritt davor. Der Forward Pass bewertet jedes Token im Vokabular, und er tut das jedes Mal mit Rechenoperationen auf denselben Zahlen. Das sollte zweimal dieselbe Antwort liefern. Die Standarderklärung besagt, dass das nicht passiert, weil die Gleitkomma-Addition nicht assoziativ ist. Addierst du dieselben Zahlen in einer anderen Reihenfolge, können die letzten Bits unterschiedlich ausfallen. Diese Reihenfolge hängt davon ab, wie die Arbeit gebatcht wurde. Und der Batch hängt davon ab, wer in diesem Moment sonst noch die API aufgerufen hat. Ich finde diese Erklärung überzeugend. Sie wird von Leuten, die Inference-Server bauen, detailliert dargelegt. Aber gemessen habe ich das nicht.
Meine Durchläufe haben außerdem mehr als eine Backend-Konfiguration durchquert. Der system_fingerprint in den Antworten nahm über die sechs Einstellungen hinweg vier unterschiedliche Werte an. Das ist eine zweite mögliche Ursache, die ich von der ersten nicht trennen kann. Von außerhalb des Serving-Stacks kann ich dir zeigen, dass es einen Boden gibt und dass keine Sampler-Einstellung ihn erreicht. Ich kann die Kiste nicht aufmachen und dir zeigen, warum das so ist. Außerdem sind das die Messwerte für den einen Prompt, den ich ausgeführt habe. Sechshundert Aufrufe machen den Boden für diesen Prompt, meinen Prompt, sichtbar und sagen überhaupt nichts darüber aus, wo sich dein Prompt einpendeln wird.
Ich konnte es nicht diagnostizieren, weil mir die Infrastruktur nicht gehört. Dir auch nicht. Nicht-Determinismus ist relativ zu der Grenze, die du sehen kannst. Der Anbieter kann die Batch-Zusammensetzung sehen und steuern, weil sie ein Input auf seiner Seite ist. Du kannst sie nicht sehen. Dieselbe Variation, die auf seiner Seite ganz gewöhnliche Buchhaltung ist, ist auf deiner Seite nicht reduzierbar.
Spielt das eine Rolle?
Ein Experiment durchzuführen und seine Zahlen zu lesen, sind zwei unterschiedliche Aufgaben. Zu entscheiden, ob diese Zahlen ein Problem beschreiben, ist eine dritte. Die Messwerte sind für alle gleich. Was sie dich kosten, hängt davon ab, was du mit der Antwort vorhattest.
Die Unterschiede in meinem Experiment waren an sich nicht dramatisch. Bei meinem Beispiel-Prompt, der nach drei Gründen fragt, warum ein flaky Test bei einem Retry bestehen könnte, sind zwei Antworten bei Temperatur 0 ohne Seed, die jeweils einmal zurückkamen, für 347 Zeichen Wort für Wort identisch. Danach gingen sie darüber auseinander, wie der Satz endet: "is reset before the retry" oder "resets between retries". Beide sagen fast dasselbe.
Eine semantische Prüfung würde sie als Beinahe-Paraphrasen bezeichnen und hätte damit recht. Eine Zusicherung auf exakte Übereinstimmung schlägt bei dem Paar jedes Mal fehl. Sie beanstandet eine Formulierung, die sie eigentlich ignorieren sollte. Die semantische Prüfung liegt bei diesem Paar richtig. Ich traue ihr aber nicht zu, eine Antwort zu beanstanden, die falsch und sprachlich flüssig ist. Nichts davon ist einfach richtig oder falsch. Ein Orakel ist eine Entscheidung darüber, was wir als Unterschied bezeichnen wollen. Und diese Entscheidung gehört zu dem, was wir testen, und nicht zum Orakel.
Vielleicht brauchen wir beides, und mehr als beides. Vielleicht greifen wir deshalb immer wieder zu Matching und Mathematik, weil es das ist, was wir haben. Und vielleicht bietet sich die Antwort eines Sprachmodells einfach nicht immer dafür an.
Kannst du es deterministisch machen?
Nicht von da aus, wo du sitzt, auch wenn eine Menge veröffentlichte Ratschläge das andeuten. Setze die Temperatur auf null, fixiere den Seed und fixiere den Modell-Snapshot. Dieses Rezept lieferte immer noch dreißig unterschiedliche Antworten auf hundert.
Ich habe die beiden Einstellungen genutzt, nach denen die Leute in der Praxis greifen. Die API dieses Modells stellt noch einen weiteren Hyperparameter zur Verfügung, der das Sampling berührt: Top-p. Der kann auch nicht helfen. Top-p behält die am höchsten bewerteten Kandidaten und verwirft den Rest. Es kann ein Token entfernen, das die Ziehung sonst vielleicht ausgewählt hätte. Aber es behält immer das Token mit der höchsten Bewertung. Und bei Temperatur null ist genau das das Token, das gewählt wird.
Ich habe es ausgeführt, anstatt es nur anzunehmen. Dreihundert weitere Aufrufe bei Temperatur null, mit Top-p auf 0.05, auf 0.5 und auf dem Standardwert von 1.0, lieferten 30, 31 und 32 unterschiedliche Antworten. Für diese Aufrufe wurde kein Seed fixiert, weil die sechs Einstellungen oben bereits gezeigt hatten, dass der Seed bei Temperatur null nichts bewirkt. Das Abschneiden auf die obersten fünf Prozent der Wahrscheinlichkeitsmasse und gar kein Abschneiden landen an genau derselben Stelle.
Temperatur, Top-p und der Seed greifen alle nach dem Forward Pass ein. Keine davon erreicht das, was hier variiert.
Es wäre ein Leichtes, ins andere Extrem zu schwingen und zu beschließen, dass ein Sprachmodell schlicht unberechenbar ist. Das ist auch falsch. Die Variation kommt nicht nur aus dem Modell, und sie kommt nicht von etwas, das du in der Anfrage setzen kannst. Die Erklärung, die ich überzeugend finde, verortet sie im Serving-Stack, der deine Anfrage zusammen mit denen anderer Leute batcht und die Reihenfolge der Rechenoperationen ändert. Das ist der Teil, den ich nicht gemessen habe. Jemand, der diesen Stack kontrolliert, kann sie herausnehmen. Thinking Machines hat batch-invariante Kernels veröffentlicht, die vLLM dazu bringen, Durchlauf für Durchlauf bitweise identischen Output zurückzugeben. Das klärt die Frage, ob es überhaupt möglich ist.
Die Erwartung, die du also mitnehmen solltest: Das letzte Stück zum Determinismus ist eine Eigenschaft der Infrastruktur, kein Parameter in der Anfrage. Wenn dir der Serving-Stack gehört, kannst du dir das einkaufen, und du wirst mit Durchsatz dafür bezahlen. Wenn du die API von jemand anderem aufrufst, wird keine Kombination der angebotenen Einstellungen etwas daran ändern. Was sich ändern müsste, liegt auf ihrer Seite der Grenze, und nichts, was ich von dieser Seite aus probiert habe, hat es erreicht.
Sollte Determinismus eine universelle Forderung sein?
Die Ausgabe zu fixieren, hat einen echten Nutzen. Das sollte man sagen, bevor man dagegen argumentiert.
Wenn du wissen willst, dass sich zwischen zwei Durchläufen etwas geändert hat, wird dir ein String-Vergleich das verraten. Das ist die billigste Methode. Der Fehler liegt darin, eine Übereinstimmung als Garantie zu behandeln und nicht als Signal, genauer hinzusehen. Eine Teststrategie, die darauf aufbaut, die Ausgabe zu fixieren, ist nicht vorsichtig. Sie verlässt sich auf eine Garantie, die dir niemand gegeben hat. Sie wird halten, bis sie es nicht mehr tut, und du wirst keine Warnung bekommen.
Bevor du noch mehr Aufwand hier reinsteckst: Was würdest du mit einem deterministischen Modell tun, wenn du eines hättest? Derselbe String bei jedem Aufruf ist Reproduzierbarkeit, keine Korrektheit. Ein Test, dessen Zusicherung eine exakte Antwort verlangt, läuft genauso freudig durch, wenn das Modell verlässlich falsch liegt. Für die Art von Problemen, die Sprachmodelle lösen sollen, willst du wahrscheinlich einen Weg finden, eine gute von einer schlechten Antwort zu unterscheiden. Wo eine richtige Antwort auf mehr als eine Art formuliert werden kann, gibt dir das weder exaktes Matching noch eine semantische Prüfung allein. Dieser Gedankengang ist besonders kritisch für automatisierte Zusicherungen. Ein menschliches Orakel lässt sich nämlich nicht auf das Testvolumen skalieren, das eine durch Sprachmodelle erweiterte Lösung wirklich braucht.
Wo ich aufgehört habe
Dieser Artikel ist die ehrliche Auswertung der Reihe von Experimenten, die ich während des Schreibens gemacht habe. Ich bin bis zum Sampler gekommen und habe dort aufgehört. Nichts, was ich erreichen konnte, hat die Ausgabe festgehalten. Und was sich ändern müsste, ist in der Anfrage nicht zugänglich.
Für manche Systeme endet die Reise, weil es nichts weiter zu lernen gibt. Für ein gehostetes Modell endet sie früher. Und das liegt nicht daran, dass die verbleibende Strecke schwierig wäre. Sie endet, weil der Teil, der sich ändern müsste, nicht uns gehört.
Das hinterlässt uns mit der Frage, mit der der nächste Artikel einsteigt. Wenn du die Antwort nicht fixieren kannst, was formulierst du stattdessen als Zusicherung? Dieser Artikel ist Was du als Zusicherung formulierst, wenn du die Antwort nicht zusichern kannst.
Danksagungen
Mit Dank an Claude und an die Modellfamilien GPT, Gemini, Grok, DeepSeek, GLM, Kimi und Qwen, die es zusammen schwerer gemacht haben, dies zu veröffentlichen, und besser, es zu lesen. Wie die Recherche und das Schreiben abgelaufen sind, ist vollständig im Begleitartikel dargelegt: Was sich ändert, wenn ein Teil deines Systems nicht-deterministisch ist.
Die Positionen hier sind meine, und das gilt auch für alles, was daran noch falsch ist.